一、为什么自建 Stirling-PDF?告别商用在线工具的隐私风险与付费套路
在日常办公、海外贸易与内容创作中,处理 PDF 几乎是每天都会遇到的高频刚需:扫描件 OCR 识别、合同多页合并、发票拆分、PDF 转 Word/Excel、敏感单证涂黑脱敏(Redaction)以及文件体积压缩。然而,市面上主流的商用在线 PDF 工具(如 Smallpdf、ILovePDF 等)普遍存在两大痛点:
- 数据隐私与商业机密外泄隐患:外贸海运提单、报关单、形式发票(PI)、财务对账单及采购合同等文件包含极其敏感的价格条款、买卖双方真实身份与银行账户。将这些核心商业凭证直接上传至不受控的第三方公网服务器,存在巨大的合规与泄露风险。
- 免费额度苛刻与付费壁垒:商用在线平台大多对免费用户限制为“每天仅限 2 次处理”、“单文件不超过 15MB”,且批量转换或 OCR 高级功能往往需要按月支付高昂的订阅费用。
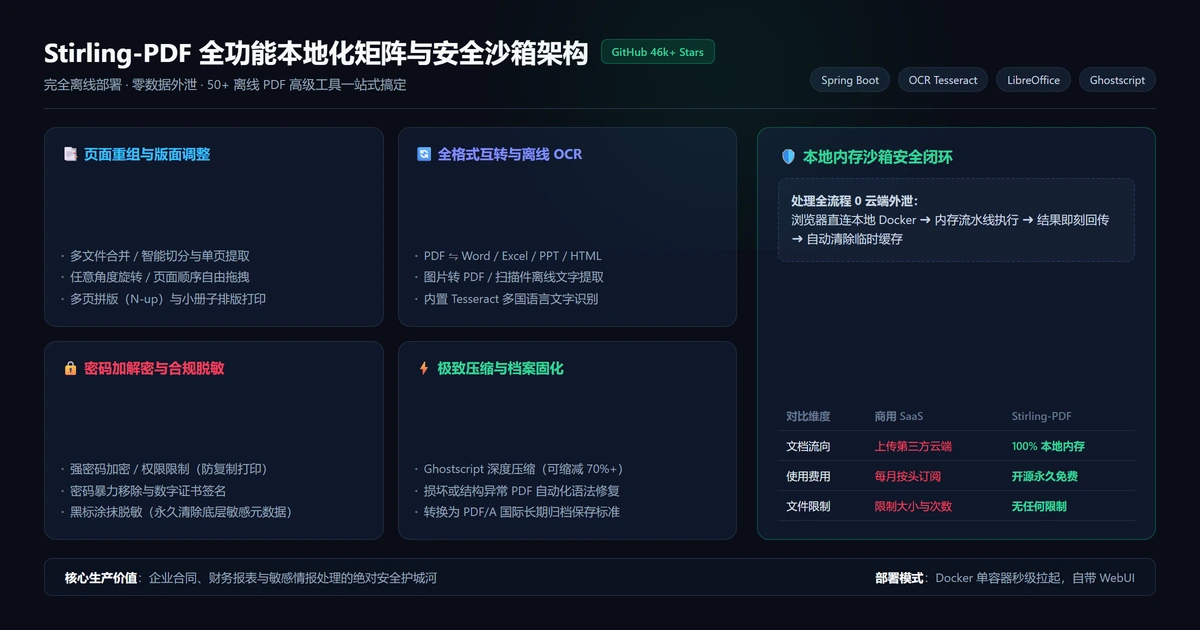
在 GitHub 狂揽超过 46,000+ Stars 的开源项目 Stirling-PDF 是目前业界公认最成熟的“本地一站式 PDF 瑞士军刀”。它基于 Spring Boot、Apache PDFBox 与 LibreOffice 构建,整合了强大的 Tesseract OCR 引擎,支持在本地或轻量 VPS 上通过 Docker 一键部署,所有文件转换均在本地内存或沙箱容器中完成,处理完毕即刻销毁临时缓存,零数据外流。
二、硬件资源开销与镜像选型建议
在动手部署前,先了解 Stirling-PDF 的官方 Docker 镜像分支与资源占用情况:
| 镜像版本 | 包含核心组件 | 空闲内存基线 | 推荐适用场景 |
|---|---|---|---|
frooodle/s-pdf:latest (Full) |
PDF 基础库 + OCR (Tesseract 5) + LibreOffice 办公文档互转 | 约 600MB ~ 900MB | 强烈推荐。功能完整,支持 Word/PPT/Excel 与 PDF 互转及 OCR 光学文字识别 |
frooodle/s-pdf:latest-fat (Ultra) |
Full 版全部功能 + 全语言 OCR 预装包 | 约 1.2GB ~ 1.8GB | 磁盘与内存充裕的本地服务器或 NAS,无需网络动态下载额外语言包 |
frooodle/s-pdf:latest-lite (Lite) |
仅包含 PDF 基础操作(合并、拆分、旋转、裁剪、水印) | 约 250MB ~ 350MB | 1C1G 极低配 VPS 或轻量边缘设备,不使用 OCR 与 Office 转 PDF 功能 |
如果你在轻量云服务器上同时托管了其他自建容器,可参考 自建服务 VPS 硬件配置与线路选型指南。通常建议为搭载 Stirling-PDF 的主机保留至少 1GB 以上空闲内存及 1GB Swap,确保大体量扫描件转换时平稳运行。
三、生产级 Docker Compose 部署实操
推荐采用 Docker Compose 进行容器编排管理。如果你习惯使用图形化容器面板,可直接通过 轻量容器管理利器 Dockge 快速部署。以下是生产就绪的配置清单:
services:
  stirling-pdf:
    image: frooodle/s-pdf:latest
    container_name: stirling-pdf
    restart: unless-stopped
    ports:
      - "127.0.0.1:8080:8080"
    environment:
      - DOCKER_ENABLE_SECURITY=false
      - INSTALL_BOOK_AND_ADVANCED_HTML_OPS=true
      - LANGS=zh_CN,en_US
      - SYSTEM_DEFAULTLOCALE=zh-CN
      - UI_APP_NAME=Seedloc PDF Studio
    volumes:
      - ./trainingData:/usr/share/tessdata
      - ./extraConfigs:/configs
      - ./logs:/logs
      - ./pipeline:/pipeline
    security_opt:
      - no-new-privileges:true
关键环境变量与配置解析
ports: ["127.0.0.1:8080:8080"]:绑定到本地回环地址,避免将未鉴权的 Web 端口直接裸露到公网。外网访问统一交由反向代理网关接入。SYSTEM_DEFAULTLOCALE=zh-CN:将 WebUI 默认界面语言直接锁定为简体中文,开箱即用无需手动切换。LANGS=zh_CN,en_US:声明启用的 OCR 识别语言。容器首次启动时会自动从官方源拉取中文与英文的训练数据包。./trainingData:/usr/share/tessdata:持久化挂载 OCR 识别库。如果服务器处于离线网络环境,可直接将chi_sim.traineddata放置在该目录下。DOCKER_ENABLE_SECURITY=false:在个人或家庭局域网内可设为 false 体验全功能极简无感访问;如果需要团队多租户协作,建议设为true并配置登录密码与用户角色权限。
四、反向代理与大文件上传限制调优(突破 413 限制)
使用 Nginx 或图形化反代面板时,处理大体量 PDF 最常遇到的报错是 413 Request Entity Too Large。这是因为反向代理层默认对 HTTP POST 上传体积进行了严格限制(例如 Nginx 默认仅 1MB)。
如果你使用 Nginx Proxy Manager 图形化反代面板,请在对应 Proxy Host 的 Advanced 配置页中加入以下指令:
# 允许单次上传最大 200MB 的 PDF 文件
client_max_body_size 200M;

# 针对复杂 OCR 与 Office 转换调高网关超时时长,防止 504 Gateway Timeout
proxy_connect_timeout 300s;
proxy_send_timeout 300s;
proxy_read_timeout 300s;
send_timeout 300s;
若通过 Cloudflare 提供 CDN 加速,请注意免费版 Cloudflare 的边缘单次上传上限为 100MB。超过 100MB 的超大扫描工程建议通过内网直接直连或在 DNS 记录中绕过 CDN 代理。
五、外贸与日常办公三大高频实战场景
1. 商业单证关键敏感信息划黑脱敏(Redaction)
外贸业务员在向新买家展示过往出货凭据(提单 BL、海关报关单、SGS 验货报告)或向同行询价时,必须隐去原买家的公司抬头、电话、真实单价与银行账户信息。Stirling-PDF 提供了业界领先的真实内容擦除(Sanitize/Redact)功能:
- 真脱敏 vs 假遮挡:传统修图软件在 PDF 上盖一个黑色矩形图层,接收方只需在 Word 或 Acrobat 中选中文本即可原样复制出底层的敏感信息;Stirling-PDF 的 Auto-Redact 会直接在底层 PDF 矢量结构中彻底剔除对应的文本编码与流数据,从根本上杜绝信息恢复的可能。
- 关键词批量匹配:支持输入关键词(如特定银行账号或公司名称),全自动对整份长文档完成高亮或黑条遮盖并下载干净的新文件。
2. 扫描件 OCR 双层可搜索化(Searchable PDF)
许多纸质发票、海运箱单拍照后保存为图片型 PDF,无法直接通过 Ctrl + F 搜索型号或批次号。利用 Stirling-PDF 内置的 Tesseract 5 引擎:
- 上传扫描文件,语言选择
Simplified Chinese + English; - 选择 OCR PDF 功能,勾选生成双层 PDF;
- 处理完成后输出的文件视觉上完全保持原始纸张印章与手写签名排版,但所有文字均已生成不可见文字层,可在 Adobe Acrobat、Edge 浏览器中自由划词复制与全文检索。
3. 极速合并与按页码无损拆分
报税或项目归档时,常需要将十数张零散的电子增值税发票汇总为一个独立 PDF。在 Web 端拖拽全部文件,界面支持直接拖拽缩略图重新调整页面顺序、旋转方向并一键合并导出,全程毫秒级完成,完全不消耗任何云端上传流量。
六、运维维护与定时自动化清理
Stirling-PDF 在设计上采用了严格的无状态流水线机制:所有上传和转换产生的临时文件均缓存在容器内的 /tmp 目录中。当浏览器端下载完毕或超时断开连接后,Spring 任务调度线程会自动执行文件解构与销毁清理,保障宿主机磁盘空间长期处于干净稳定的基线水平。
更多生产级自建效率工具与容器服务实战,欢迎常逛 建站运维专栏 探索更优雅的数字化工作流!
评论