一、为什么个人与小团队需要私有化 AI 知识库?
通用大模型(如 ChatGPT、Claude、DeepSeek)虽然通晓百科,但面对你的私有业务场景时往往力不从心:外贸团队上百份产品规格书(Datasheet)、历史报价单与各国清关要求,或者技术团队内部的运维手册与排查笔记,通用模型既读不到,直接上传到公有云又存在商业机密与客户隐私泄露风险;此外,每次提问都把整篇长文档塞进上下文,API Token 账单也会迅速膨胀。
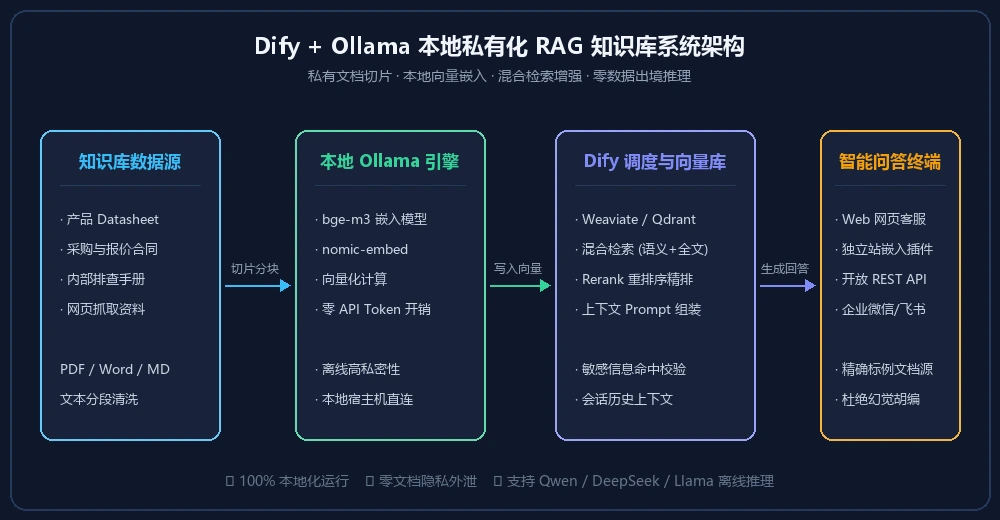
Dify 是目前全球最受欢迎的开源 LLM 应用开发与 RAG(检索增强生成)知识库平台。通过 Docker 私有化部署 Dify,并与局域网内的 Ollama 本地大模型与向量模型 结合,你可以零 API 成本将 PDF、Word、Markdown 乃至网页文档自动切片向量化,搭建出精准引用内部资料、绝不胡编乱造的专属 AI 问答助手与智能客服。
二、Dify + Ollama 私有化方案核心优势对比
| 评估维度 | Dify + Ollama 自建方案 | 公有云 SaaS 知识库 | 纯聊天窗口上传文档 |
|---|---|---|---|
| 数据隐私与合规 | 文档切片、向量库与推理全程不出内网 | 核心业务文档存储在第三方服务器 | 受限于平台隐私条款,存在训练采样风险 |
| 检索精度(RAG) | 支持混合检索(向量 + 全文)与 Rerank 重排序 | 黑盒检索,难以针对专业术语调优分段 | 长文档容易丢失中间细节(Lost in the Middle) |
| 长期运行成本 | 本地 Embedding 零边际成本,支持按需混用低价 API | 按坐席数、存储空间与调用次数多重计费 | 每次对话重复消耗海量输入 Token |
| 工作流扩展 | 内置可视化 Agent 编排,可对外发布 API 或嵌入网页 | 接口封闭,二次集成受限 | 仅限单人对话,无法对接业务系统 |
三、实战部署:使用 Docker Compose 一键启动 Dify
Dify 官方容器栈包含 Web 前端、API 服务、Worker 异步队列、PostgreSQL、Redis 以及默认向量数据库 Weaviate。服务器建议配置至少 2 核 CPU、4GB 内存(若同机运行 Ollama,建议 8GB 以上内存或开启 Swap,做好 Linux VPS 基础安全加固)。
1. 克隆官方编排仓库并初始化环境变量
git clone --depth 1 https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
如果服务器上 80/443 端口已被 Nginx Proxy Manager 反向代理 占用,请编辑 .env 文件修改 Dify 对外暴露的 HTTP 端口:
EXPOSE_NGINX_PORT=8080
EXPOSE_NGINX_SSL_PORT=8443
2. 启动容器集群与创建管理员账号
docker compose up -d
docker compose ps
等待全部容器状态变为 Up 后,访问 http://服务器IP:8080/install 完成初始化管理员注册。日常维护这套多容器编排时,也可以挂载到 Dockge 容器管理面板 中实时查看日志与更新镜像。
四、接入 Ollama 与本地 Embedding 模型构建 RAG 知识库
进入 Dify 控制台右上角 设置 → 模型供应商 → Ollama,即可将本地推理服务与商用大模型(如 DeepSeek / GLM-4 等高性价比国内模型)混合编排:
1. 拉取中文友好的 Embedding 向量模型
RAG 知识库的检索准确度,70% 取决于 Embedding 模型的语义理解能力。在运行 Ollama 的机器上拉取经过中文深度优化的 bge-m3 模型(体积小、支持多语言长文本):
ollama pull bge-m3
ollama pull qwen2.5:7b
在 Dify 的 Ollama 供应商设置中,分别添加 bge-m3(模型类型选 Text Embedding)和 qwen2.5:7b(模型类型选 LLM)。注意:如果 Dify 运行在 Docker 容器内而 Ollama 运行在宿主机,基础 URL 请填写 http://host.docker.internal:11434 或宿主机内网 IP,不要填 127.0.0.1。
2. 创建知识库与分段清洗调优
- 点击顶部导航 知识库 → 创建知识库,上传你的产品手册 PDF、FAQ 表格或从 memos 私有化知识卡片 导出的 Markdown 笔记。
- 分段设置:推荐使用“父子分段”或自定义分段(分段最大长度设为
500~800字符,分段重叠度50~100字符),既能保留完整上下文,又不会稀释核心关键词。 - 检索设置:开启混合检索(向量检索 + 全文关键词检索),TopK 设为
4~6,Score 阈值设为0.5,这样无论是模糊语义提问还是精确查找产品型号编码都能一击即中。
3. 创建知识库聊天助手并关联自动化工作流
在 Dify 工作室 → 创建空白应用,选择“聊天助手”,在上下文中添加刚才建好的知识库,并在系统提示词(System Prompt)中约束模型行为:
你是一名专业的技术与业务顾问。请严格依据【上下文】中的知识库内容回答用户问题。
如果知识库中没有相关信息,请明确告知“知识库中暂无该项记录”,严禁编造参数或价格。
点击右上角“发布”,即可一键生成独立 Web 问答链接、网站右下角悬浮气泡代码,或生成 API 密钥交给 n8n 自动化工作流 调用,实现新邮件/工单自动检索知识库并生成回复草稿。
五、生产环境数据备份与安全建议
- 持久化卷异地备份:Dify 的所有知识库切片、向量索引与对话记录均存储在
dify/docker/volumes目录下。请务必将该目录纳入 1Panel 远程对象存储定时冷备份,防止磁盘故障导致精心清洗的知识库丢失。 - 访问权限控制:对外嵌入企业官网时,务必在 Dify 应用后台设置每分钟提问频率限制(Rate Limit),并通过反向代理开启 HTTPS 加密传输。
六、总结与下一步阅读
如果说 Ollama 解决了私有化大模型的“大脑”问题,n8n 解决了跨应用自动化的“手脚”问题,那么 Dify 就是连接私有数据与业务场景的“记忆中枢”。三者结合,足以让个人开发者与中小型团队以极低的硬件成本拥有一套安全可控的企业级 AI 生产力平台。更多 AI 实战教程请访问本站 AI 与效率专题。
推荐继续阅读:
• Ollama + Open WebUI 极简私有化部署:在轻量 VPS/NAS 打造专属 ChatGPT
• Docker 部署 n8n 工作流自动化:可视化串联 AI 模型与自建服务的效率引擎
• 1Panel 面板一键托管远程对象存储:自动化多版本冷备份与灾难恢复指南
评论